Поисковые системы отдают приоритет страницам, демонстрирующим глубокую тематическую релевантность. Показатель **TF-IDF** помогает опытным специалистам по цифровому маркетингу измерить этот важный информационный вес, оценивая, как часто конкретное слово встречается на активной странице по сравнению с его редкостью в более широком круге документов конкурентов. Эта математическая концепция легко превосходит простую плотность ключевых слов, поскольку она отфильтровывает общий «пустой» контент, уравновешивает критически важные вариации слов и вознаграждает реальную контекстную глубину.
Для эффективной поисковой оптимизации (SEO) необходима всесторонняя тематическая глубина, а не бессмысленное повторение фраз. Немедленно устраните пробелы. Опытные контент-менеджеры добиваются превосходных результатов в органическом поиске, тщательно анализируя документы высокорейтинговых конкурентов, выявляя скрытую ключевую лексику и вплетая недостающие отраслевые фразы в заголовки, чтобы показать поисковым роботам полное тематическое охват.
Сегодня Google использует высокоразвитые модели обработки естественного языка для оценки контекста и удовлетворения сложных поисковых запросов. Даже с учетом этих обновлений семантических алгоритмов, традиционные статистические методы оценки по-прежнему обеспечивают базовый первый фильтр на ранних этапах поиска страниц-кандидатов. Эти чистые данные предлагают прозрачную и действенную дорожную карту для авторов поисковых запросов, которые хотят соответствовать современным ожиданиям поисковых систем и создать неоспоримый тематический авторитет, не полагаясь на чистую догадку.
Сбалансированное использование ключевых слов предотвращает серьезные штрафы за чрезмерную оптимизацию и делает ваш текст естественным, читабельным и привлекательным для вашей целевой аудитории. Тщательно отслеживайте свои показатели. Это практическое руководство подробно описывает, как современное SEO-программное обеспечение автоматизирует весь процесс расчета, чтобы выявить скрытые закономерности в лексике конкурентов, позволяя вам проводить сбалансированную семантическую оптимизацию и успешно занимать лидирующие позиции в поисковой выдаче.
Что такое TF-IDF в продвинутом SEO?
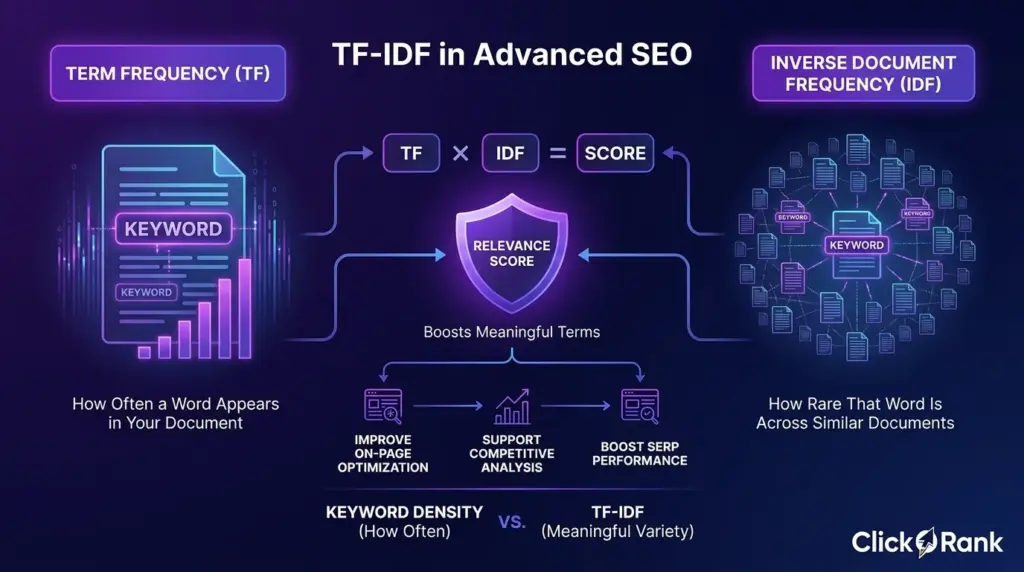
TF-IDF (частота термина – обратная частота документа) — это показатель важности слова на странице по сравнению с другими страницами на ту же тему. Он объединяет два числа: TF, показывающее, как часто слово встречается в вашем документе, и IDF, показывающее, насколько редко это слово встречается в наборе похожих документов. Перемножив их, вы получите показатель, который повышает значимость терминов, часто встречающихся на вашей странице, но редко встречающихся в других местах. В SEO это помогает выявлять ключевые тематические термины, избегать чрезмерного использования общих слов и видеть, что упоминают конкуренты.
Как простыми словами определить TF-IDF?
Частота термина – обратная частота документа (TF-IDF) – это статистический показатель, измеряющий важность слова в документе по сравнению с его важностью в группе документов. Он уравновешивает две противоположные силы:
- Частота термина (TF): как часто термин появляется на вашей странице.
- Обратная частота документа (IDF): насколько редко термин встречается в Интернете или корпусе.
Проще говоря, TF-IDF выделяет «особые ингредиенты» в вашем контенте, сравнивая их частотность на вашей странице с их редкостью на аналогичных страницах. Слова, которые часто встречаются в вашем документе, но редко встречаются в корпусе, оцениваются выше, что свидетельствует о высокой релевантности.
Почему TF-IDF важен для поисковой оптимизации?
Поисковые системы стремятся предоставлять наиболее релевантные страницы по каждому запросу. TF-IDF помогает оценивать релевантность, показывая, какие термины имеют реальную информационную ценность.
Применительно к SEO анализ TF-IDF может помочь вам:
- Улучшите оптимизацию страницы: найдите семантически связанные термины и органично интегрируйте их, чтобы ваш контент более полно охватывал тему.
- Проведите конкурентный анализ: сравните свой профиль сроков TF-IDF с профилями ведущих конкурентов, чтобы выявить пробелы.
- Повысьте эффективность SERP: страницы, отражающие правильную тематическую лексику, как правило, ранжируются лучше при прочих равных условиях.
Чем TF-IDF отличается от плотности ключевых слов?
Плотность ключевых слов измеряет только повторение термина на одной странице. TF-IDF добавляет второй уровень, исключая слова, которые встречаются повсеместно.
Таким образом, хотя плотность может подтолкнуть вас к повторению ключевого слова, TF-IDF поощряет контекстное разнообразие и препятствует перенасыщению текста.
Другими словами: плотность спрашивает «Как часто вы это говорили?»
TF-IDF спрашивает: «Сказали ли вы правильные поддерживающие слова, и имеют ли они смысл?»
Как работает TF-IDF в SEO?
Что означает «Частота термина» в TF-IDF?
Частота встречаемости (TF) измеряет частоту появления ключевого слова в документе. Простейший способ расчёта TF:
TF = (Количество вхождений термина) ÷ (Общее количество слов в документе)
Более высокий TF обычно означает, что термин важен для данной страницы, но TF сам по себе слаб, поскольку доминировать могут общеупотребимые слова.
Что представляет собой «обратная частота документа»?
Обратная частота встречаемости документа (IDF) измеряет, насколько редко встречается тот или иной термин в корпусе документов.
- Если слово встречается на многих страницах (например, «лучший», «руководство», «и»), IDF снижает его вес.
- Если слово встречается на меньшем количестве релевантных страниц, IDF увеличивает его вес.
Это не позволяет стоп-словам и общим терминам искажать релевантность.
Как сочетаются TF и IDF для расчета релевантности?
TF-IDF рассчитывается следующим образом:
ТФ-ИДФ = ТФ × ИДФ
Этот продукт выделяет слова, которые являются:
- Часто встречается на вашей странице
- Редко встречается на страницах конкурентов
Итак, TF-IDF помогает раскрыть, что представляет собой ваш контент. конкретно о чем, а не о том, что говорится на каждой странице по этой теме.
Почему TF-IDF считается более продвинутым методом, чем базовый анализ ключевых слов?
Потому что его невозможно «подкрутить» одним лишь повторением. TF-IDF естественным образом отфильтровывает лишнее и отдаёт предпочтение специфической тематической лексике. Это делает его гораздо более эффективным инструментом для оценки глубины темы, чем простая частота.
Как TF-IDF применяется в оптимизации контента?
Понимание TF-IDF полезно, но настоящая ценность проявляется при его применении к реальному контенту. В SEO TF-IDF заключается не в добавлении большего количества ключевых слов на страницу, а в приведении вашего словаря в соответствие с ожиданиями поисковых систем по теме. Когда инструменты сравнивают TF-IDF на страницах с высоким рейтингом, они выявляют повторяющиеся термины, подтемы и семантические закономерности, которые указывают на глубину. Это даёт вам практичный способ повысить релевантность, не гадая, что означает «полный охват».
Как TF-IDF может улучшить таргетинг ключевых слов в SEO?
Инструменты TF-IDF сравнивают вашу страницу с результатами поиска с самым высоким рейтингом и выявляют:
- Термины, которые конкуренты постоянно используют
- Важные подтемы, которые вы не рассмотрели
- Поддерживающие фразы, усиливающие семантическое покрытие
Затем вы естественным образом вплетаете эти термины в заголовки и абзацы, повышая релевантность без переполнения.
Как TF-IDF помогает выявлять пробелы в контенте?
Анализ пробелов TF-IDF в основном заключается в следующем:
«О чём пишут лучшие страницы, чего не пишет моя?»
Если конкуренты используют набор слов с высокими показателями TF-IDF, а вы нет, это явный признак того, что ваше покрытие неполное.
Почему TF-IDF используется для балансировки вариативности ключевых слов и контекста?
TF-IDF наказывает за чрезмерное повторение общих терминов и поощряет более богатый словарный запас. Это подталкивает вас к следующему:
- Используйте синонимы
- Добавить термины, связанные с сущностями
- Подтемы обложки
- Ответьте на смежные вопросы
Это напрямую соответствует принципам семантического SEO.
Как TF-IDF может помочь в создании семантического контента?
Семантическое SEO направлено на удовлетворение намерений, а не просто на соответствие ключевым словам. TF-IDF помогает выявить лексику, естественным образом связанную с вашей темой.
Чтобы глубже изучить оптимизацию, основанную на намерениях, используйте это в сочетании с нашим руководство по семантическому SEO.
Каковы преимущества использования TF-IDF в SEO?
TF-IDF остаётся популярным в продвинутой SEO-оптимизации, поскольку предлагает измеримый способ оценки тематической релевантности. Вместо того, чтобы полагаться на интуицию или устаревшие проверки плотности, TF-IDF помогает выявить конкретные термины и темы, которые группируются вокруг высокоэффективных страниц. Когда вы естественным образом включаете эти термины, поисковые системы интерпретируют ваш контент как более соответствующий намерению и глубине темы. TF-IDF также делает анализ конкурентов более конкретным: вы можете определить, на каких страницах ранжирования акцент делается на том, где охват недостаточен, и какие концепции, возможно, стоит расширить.
Как TF-IDF повышает релевантность контента для поисковых систем?
Добавление высокоценных терминов TF-IDF повышает тематическую ясность. Поисковые системы могут более уверенно соотносить вашу страницу с поисковым запросом, поскольку ваш контент отражает ту же семантическую экосистему, что и надежные рейтинговые объявления.
Почему TF-IDF полезен для анализа конкурентных ключевых слов?
TF-IDF позволяет оценить словарный запас конкурентов. Вместо того, чтобы гадать, почему другая статья занимает высокие позиции, вы можете увидеть:
- Какие термины они подчеркивают
- Какие темы они включают
- Чего не хватает твоему?
Это превращает анализ конкурентов в настоящую дорожную карту оптимизации.
Как TF-IDF может улучшить внутреннюю SEO-оптимизацию?
TF-IDF помогает оптимизировать:
- Заголовки и подзаголовки
- Основная копия
- Часто задаваемые вопросы (FAQ)
- Альтернативный текст изображения
- Внутренние соединительные якоря
Главное — не втискивать термины в текст, а расширять разделы там, где это имеет смысл.
Какую роль играет TF-IDF в семантическом поиске?
Хотя современные модели Google выходят за рамки TF-IDF, принцип по-прежнему соответствует принципу работы релевантности: важные термины в содержательном контексте в рамках тематической группы. TF-IDF — это просто простой способ для людей приблизиться к этому.
Каковы ограничения TF-IDF в SEO?
TF-IDF полезен, но это не волшебный инструмент ранжирования, и использование его как такового обычно приводит к обратным результатам. Эта метрика статистическая, а не семантическая. Это означает, что она может упустить нюансы, неправильно интерпретировать синонимы или подтолкнуть авторов к неестественным формулировкам, если они слишком агрессивно гонятся за рейтингом. Качество инструмента также имеет значение, поскольку TF-IDF настолько же точен, насколько точен корпус текста конкурента, на котором он основан. Современные поисковые системы теперь полагаются на системы обработки естественного языка, основанные на смысловом анализе, поэтому TF-IDF следует использовать как вспомогательное руководство, а не как основную стратегию.
Почему чрезмерная зависимость от TF-IDF может нанести вред качеству SEO-контента?
Потому что TF-IDF — это математика, а не повествование. Если вы слишком усердно гонитесь за результатами, вы рискуете:
- Неловкая формулировка
- Салатные абзацы с ключевыми словами
- Более низкая читаемость
- Более низкая удовлетворенность пользователей
Современные рейтинги больше ценят статьи, написанные с упором на людей, чем статистическое совершенство.
Как TF-IDF справляется с синонимами и семантикой?
TF-IDF рассматривает каждое слово как отдельное. Он не «знает», что:
- Ребенок = младенец
- Юрист = адвокат
- SEO-аудит = технический аудит
Поэтому отчеты TF-IDF могут преувеличивать то, чего не хватает, если конкурент использует синоним, который вы уже осветили.
Почему TF-IDF менее эффективен без высококачественных данных?
Качество TF-IDF зависит от качества используемого корпуса. Если инструмент использует:
- Слишком мало страниц конкурентов
- Устаревшие страницы результатов поиска
- Нерелевантные источники
…ваши рекомендации быстро становятся шумными.
Как алгоритмы поисковых систем снижают зависимость от TF-IDF?
Теперь Google добавляет к системе подсчета очков в стиле TF-IDF:
- Векторные вложения
- Понимание сущности
- Моделирование намерений
- сигналы EEAT
- Данные о взаимодействии
Вот почему TF-IDF полезен для руководства, а не как рычаг ранжирования сам по себе.
Как поисковые системы используют TF-IDF в ранжировании?
Изначально поисковые системы использовали оценку релевантности в стиле TF-IDF для сопоставления страниц с запросами. Сегодня алгоритм ранжирования Google гораздо более продвинут, но принципы TF-IDF по-прежнему остаются на заднем плане, являясь частью раннего поиска и проверки лексической релевантности. TF-IDF можно рассматривать как сигнал «первого прохода», который помогает поисковым системам сузить круг потенциальных страниц до того, как более глубокие семантические модели, такие как BERT, оценят истинное значение и степень удовлетворенности. Именно поэтому TF-IDF по-прежнему важен для SEO-специалистов: он отражает словарные шаблоны, ожидаемые поисковыми системами в тематическом пространстве, даже если он больше не является самостоятельным фактором ранжирования.
Использует ли Google до сих пор TF-IDF в своих алгоритмах?
Не как самостоятельный фактор ранжирования. Логика, подобная TF-IDF, может всё ещё существовать на ранних этапах поиска, но современное ранжирование зависит от гораздо более содержательных семантических и качественных сигналов.
Как TF-IDF соотносится с современными факторами ранжирования, такими как BERT?
- TF-IDF: статистически измеряет важность термина
- Модели BERT/NLP: понимание смысла в контексте.
Результаты TF-IDF важные слова.
BERT понимает важные идеи.
Почему TF-IDF по-прежнему актуален в продвинутых SEO-стратегиях?
Потому что это даёт SEO-специалистам быстрый и понятный способ проверки релевантности и глубины. В сочетании с оценкой намерений и авторитетности темы это по-прежнему мощный инструмент оптимизации.
Как поисковые системы применяют TF-IDF вместе с моделями NLP?
Обычно слоями:
- Оценка в стиле TF-IDF помогает сузить круг страниц-кандидатов.
- Модели НЛП оценивают смысл, намерение и удовлетворение.
Таким образом, TF-IDF скорее является «первым фильтром», а не окончательным судьей.
Как SEO-инструменты могут реализовать анализ TF-IDF?
Большинство SEO-специалистов не рассчитывают TF-IDF вручную; эту работу выполняют инструменты, анализируя результаты поисковой выдачи, создавая корпус конкурентов и автоматически генерируя оценки важности терминов. Ключевым моментом является понимание того, как эти инструменты интерпретируют TF-IDF, чтобы вы могли разумно использовать их рекомендации. Хороший инструмент для расчета TF-IDF не просто перечисляет слова; он показывает, как распределяется лексика на верхних позициях результатов поиска, какие термины отсутствуют и где вы, возможно, чрезмерно используете общие фразы. Это превращает TF-IDF в практический компас для редактора.
Какие SEO-инструменты предоставляют возможности анализа TF-IDF?
Большинство основных инструментов поддерживают отчеты TF-IDF, включая:
- SEMRush
- ryte
- СерферSEO
- SEO-возможности
- TextRazor
Эти инструменты анализируют результаты поиска, вычисляют рейтинг терминов и предлагают варианты недостающей лексики.
Как можно использовать отчеты TF-IDF для проведения контент-аудита?
Процедура:
- Выберите страницу, которая работает неэффективно
- Проведите TF-IDF против сильнейших конкурентов
- Определите недостающие важные термины
- Развернуть соответствующие разделы
- Добавьте внутренние ссылки, где необходимо.
- Повторно отслеживайте рейтинги и вовлеченность.
Почему TF-IDF полезен при контент-анализе конкурентов?
Потому что это выявляет «тематическую терминологию», на которую полагаются конкуренты, предоставляя вам четкие ориентиры для повышения глубины и ясности изложения.
Как можно автоматизировать TF-IDF с помощью программного обеспечения для SEO?
Современные инструменты полностью автоматизируют математику, предоставляя:
- Списки терминов
- Диапазоны применения
- Оповещения о пробелах
- Флаги чрезмерного использования
Поэтому вы можете сосредоточиться на контент-стратегии, а не на расчетах.
Как можно сочетать TF-IDF с другими методами SEO?
TF-IDF наиболее эффективен, когда поддерживает более масштабную стратегию. Сам по себе он может подсказать, какие термины встречаются на успешных страницах, но не объясняет их намерение, структуру, релевантность сущностей или то, действительно ли контент удовлетворяет пользователей. Сочетание TF-IDF с тематической кластеризацией, семантическим SEO, оптимизацией сущностей и картированием намерений делает его гораздо более эффективным. Он помогает убедиться, что ваши опорные страницы и кластеры отражают реальную лексику SERP, а ваши вспомогательные публикации заполняют необходимые семантические пробелы.
Каким образом TF-IDF поддерживает стратегии тематических кластеров?
TF-IDF показывает, какие термины относятся к:
- Ваша опорная страница
- Ваши кластерные части
- Ваши часто задаваемые вопросы
Это делает кластеризацию более соответствующей реальному словарю SERP.
Почему TF-IDF важен в LSI и семантическом SEO?
Хотя Google не использует LSI в буквальном смысле, TF-IDF — один из самых простых способов для авторов находить семантически связанные термины.
Если вам нужен такой фон, смотрите наш LSI глубокое погружение.
Как можно объединить TF-IDF с SEO на основе сущностей?
Используйте TF-IDF для выявления атрибутов сущностей и связанных с ними понятий, а затем подкрепите их следующими методами:
- Структурированные заголовки
- Разметка схемы
- Внутренние ссылки
- Примеры и определения
Как TF-IDF работает с анализом намерений ключевых слов?
TF-IDF раскрывает общую лексику для каждой категории намерений: информационные, транзакционные и сравнительные, помогая вашему контенту естественным образом соответствовать намерениям.
Как рассчитать TF-IDF для целей SEO?
Даже если вы никогда не занимаетесь математикой самостоятельно, понимание того, как рассчитывается TF-IDF, поможет вам правильно интерпретировать результаты инструмента. TF-IDF основан на двух понятиях: частоте термина (насколько часто слово встречается на вашей странице) и обратной частоте документа (насколько редко это слово встречается на страницах конкурентов). Перемножив их, вы получите вес релевантности, который выделяет термины, часто встречающиеся в верхних результатах поиска, но недостаточно представленные в вашем контенте. SEO-инструменты применяют сглаживание, логарифмическое масштабирование и усреднение корпуса, поэтому сухие цифры имеют меньшее значение, чем направление.
Какие математические шаги лежат в основе TF-IDF?
- TF: частота термина на странице
- IDF: редкость в разных корпусах
- Умножить TF × IDF
Большинство инструментов применяют сглаживание и логарифмическое масштабирование, чтобы избежать искажений.
Как можно использовать Python для вычисления TF-IDF?
Такие библиотеки, как scikit-learn, позволяют быстро генерировать матрицы TF-IDF. Они полезны для крупномасштабных аудитов, но для большинства команд могут оказаться излишними, если только вы не используете собственные рабочие процессы.
Почему ручные расчеты TF-IDF нецелесообразны для SEO?
Поскольку данные SERP ежедневно меняются и включают тысячи документов, всегда используйте автоматизированные инструменты.
Как SEO-платформы упрощают реализацию TF-IDF?
Oни:
- Собирайте данные с живых конкурентов
- Создайте корпус терминов
- Вычислить TF-IDF
- Выявить полезные идеи
Таким образом, вы можете проводить оптимизацию, не прибегая к формулам.
Как TF-IDF влияет на контент-стратегию?
TF-IDF — это больше, чем просто инструмент для оптимизации контента. При анализе нескольких результатов поиска в одной нише шаблоны TF-IDF выявляют повторяющиеся кластеры терминов, которые дают представление о том, как выглядит экосистема темы. Это помогает планировать опорные страницы, поддерживать публикации кластера и расширять раздел часто задаваемых вопросов, основываясь на реальных конкурентных формулировках, а не на предположениях. Это также помогает определить, где ваша текущая библиотека контента скудна, а где более полное семантическое покрытие может открыть новые возможности для рейтинга. В этом разделе мы рассмотрим, как TF-IDF поддерживает долгосрочное планирование, сбалансированное использование ключевых слов и более продуманный редакционный выбор, привязанный к авторитетности темы.
Как TF-IDF может выделить отсутствующие семантические ключевые слова?
Это позволяет выявить термины, которые ожидаются в результатах поиска по данной теме, что помогает заполнить семантические пробелы.
Почему TF-IDF ценен для создания длинных видеороликов?
Длинные страницы должны быть обширными. TF-IDF показывает подтемы и вспомогательную лексику, которые необходимо охватить для достижения конкурентоспособного рейтинга.
Каким образом TF-IDF обеспечивает сбалансированное использование ключевых слов?
Он отмечает:
- Отсутствуют ключевые термины
- Чрезмерное использование повторяющихся терминов
Поэтому ваш контент остается естественным.
Как прогнозы TF-IDF могут формировать редакционные календари?
Запустите TF-IDF по нише, и вы обнаружите повторяющиеся кластеры терминов, которые охватывают конкуренты, — отличные подсказки для:
- опорные столбы
- новые страницы кластера
- секции расширения
Каково будущее TF-IDF в продвинутой SEO-оптимизации?
Значение TF-IDF как концепции прямого ранжирования будет снижаться, но как практический инструмент SEO он никуда не исчезнет. Поиск всё глубже проникает в семантический и основанный на искусственном интеллекте поиск, но TF-IDF по-прежнему обладает одним преимуществом: он интерпретируем. Он даёт людям быстрый и надёжный способ приблизительно оценить, что такое «тематическая полнота» с точки зрения статистики. Со временем инструменты TF-IDF, вероятно, будут сочетаться с оценкой сущностей и векторным сходством, создавая гибридные модели релевантности, которые ближе к принципам работы современного поиска. В этом разделе рассматривается роль TF-IDF в поиске с использованием искусственного интеллекта, причины, по которым семантические системы снижают зависимость от сырой статистики по терминам, и то, как TF-IDF остаётся полезным в глобальных рабочих процессах SEO.
Как модели на основе ИИ изменят роль TF-IDF?
TF-IDF не исчезнет, но перейдет на вспомогательную роль. Поиск ИИ основан на смысловом содержании, но TF-IDF по-прежнему полезен для быстрой проверки релевантности.
Почему семантический поиск может снизить вес TF-IDF?
Потому что теперь векторные представления и сущности улавливают нюансы, недоступные TF-IDF. Но TF-IDF по-прежнему помогает статистически определить, как выглядит «покрытие темы».
Как TF-IDF может адаптироваться к меняющимся алгоритмам поисковых систем?
Ожидаются гибридные подходы, в которых TF-IDF сочетается с:
- Оценка сущностей
- Векторное сходство
- Моделирование намерений
Какое место займет TF-IDF в глобальных SEO-стратегиях?
Международная поисковая оптимизация (SEO) по-прежнему выигрывает от использования TF-IDF, поскольку он помогает сопоставлять локальный словарный запас и региональные ожидания SERP по языковому корпусу.
Хотите узнать, каких именно ключевых слов и семантических терминов не хватает в вашем контенте, без догадок и нагромождения? Проведите быструю проверку контента по стандарту TF-IDF прямо здесь. ClickRank AI SEO Agent — получите чистый список пробелов в терминах, диапазонов использования и возможностей внутренних ссылок, которые вы сможете исправить за считанные минуты.
В чем разница между TF-IDF и плотностью ключевых слов в SEO?
Плотность учитывает повторения в одном документе. TF-IDF измеряет повторения и редкость во всех документах, что делает его более интеллектуальным инструментом релевантности.
Насколько точен алгоритм TF-IDF для прогнозирования позиций в поисковых системах?
Это полезно с точки зрения направления, но рейтинги зависят от многих других факторов, таких как авторитетность, UX и соответствие намерениям.
Все ли современные SEO-инструменты по-прежнему полагаются на анализ TF-IDF?
Многие включают его в свои программы, но большинство сейчас сочетают его с семантическим анализом/анализом естественного языка.
Может ли TF-IDF улучшить оптимизацию контента для глобальной аудитории?
Да. Это помогает определить ключевые слова, специфичные для региона, в каждом языковом корпусе.
Как часто следует проводить анализ TF-IDF содержимого веб-сайта?
Запускайте его при: - Публикации нового контента - Обновлении страницы, занимающей лидирующие позиции - Ежеквартальном аудите групп контента
Какие распространённые ошибки допускаются при применении TF-IDF в SEO?
- Неестественное навязывание терминов - Чрезмерная оптимизация результатов - Использование слабых корпусов - Рассмотрение TF-IDF как фактора ранжирования
Как TF-IDF взаимодействует с семантической SEO-оптимизацией и моделями обработки естественного языка?
TF-IDF отвечает за лексическую релевантность. Модели обработки естественного языка (NLP) отвечают за смысл. Вместе они помогают создавать страницы, соответствующие как словам, так и смыслу текста.